工业 · 技术观察|机器人上产线:分拣成功率到96%
图:工业早知道·技术观察
11月10日,谷歌DeepMind发布了新一代机器人视觉-语言-动作模型Gemini Robotics 2.5。随模型一同公布的,还有一份来自真实汽车工厂的成绩单:Apollo 2人形机器人在奔驰的两座工厂里做零部件分拣,成功率96%(据DeepMind官方博客)。
01 机器人换了个更快的「大脑」
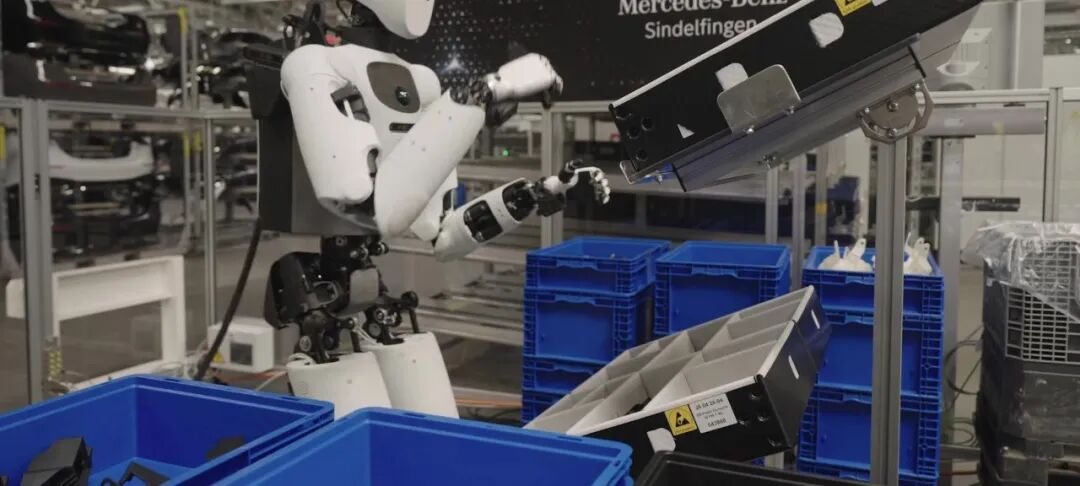
图源:Google DeepMind官方视频截帧(Apollo 2于奔驰辛德尔芬根工厂)
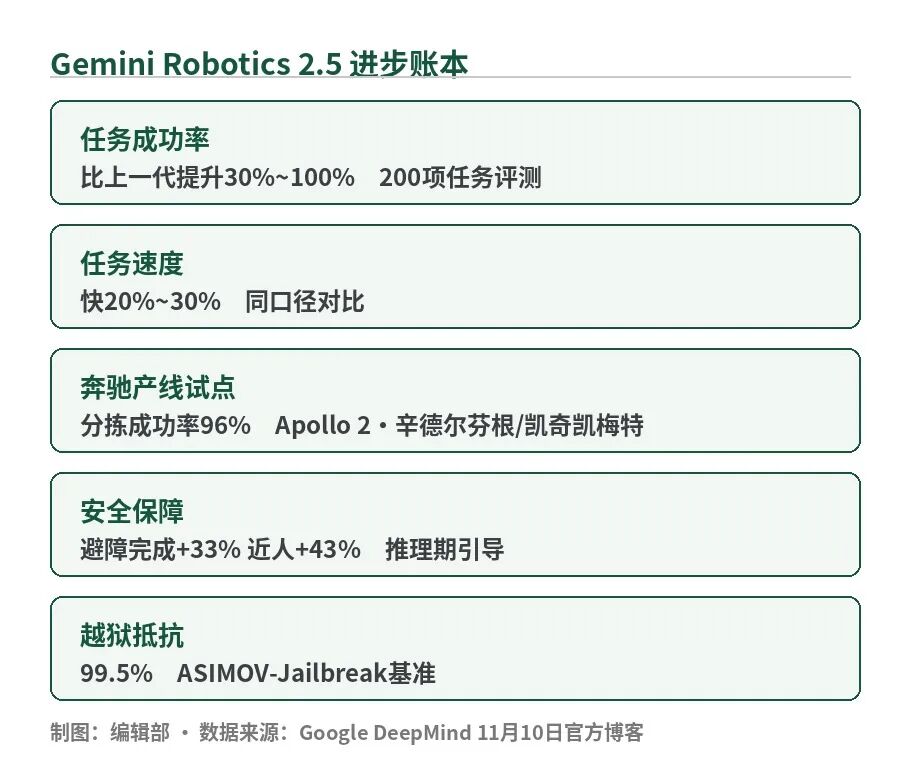
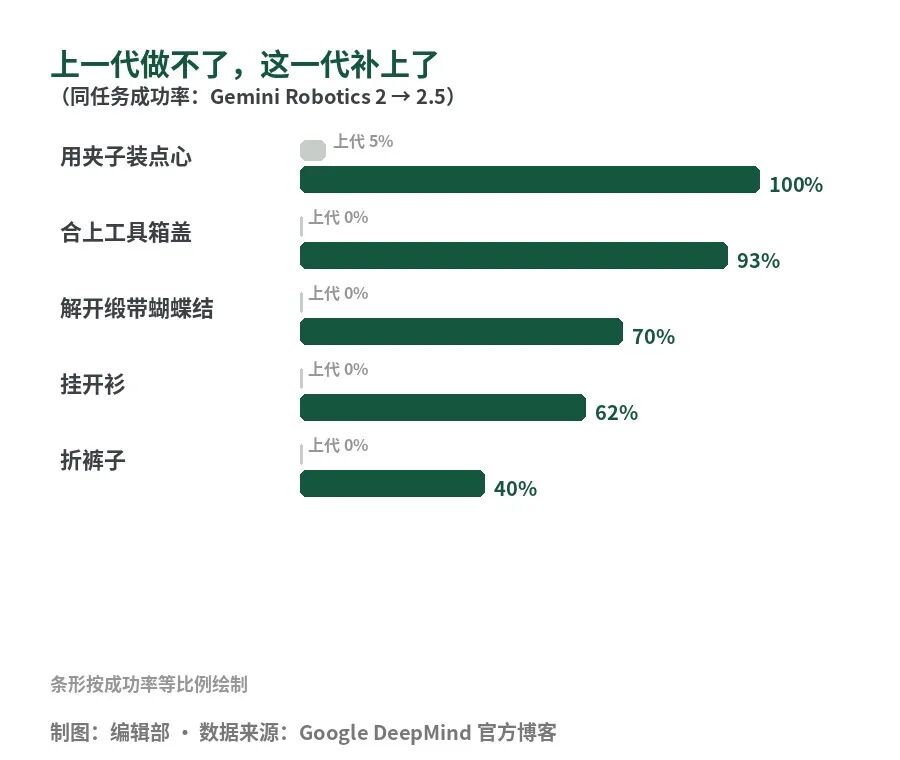
这类模型被称为VLA,即视觉-语言-动作模型:机器人看画面、听指令,然后直接输出动作。DeepMind在200项任务上做了对比评测,Gemini Robotics 2.5的任务成功率比上一代提升30%到100%,完成速度加快20%到30%。评测项目里不乏精细活:用夹子把点心装进盒子、解开缎带蝴蝶结、挂一件开衫——这些任务上一代模型的成功率普遍在5%以下,甚至为零。
制图:编辑部 · 数据来源:Google DeepMind官方博客
02 怎么做到的:先在仿真里练几千次
速度的秘密在训练环节。DeepMind把10月发布的Gemini 4 Argon前沿模型引入了机器人训练:Argon在虚拟环境里带着机器人模型跑数千次练习,还会回看失败录像,分析抓取为什么脱手、摆放为什么偏移,据此调整训练方案。整套迭代在四个月内完成,而过去这类能力升级往往以年计。
真机侧采用双模型分工:具身推理模型负责跟踪工作流程,知道现在做哪一步、下一步是什么;动作模型控制手臂和五指灵巧手,抓取出现偏差时实时纠正。
03 奔驰产线的96%怎么来的
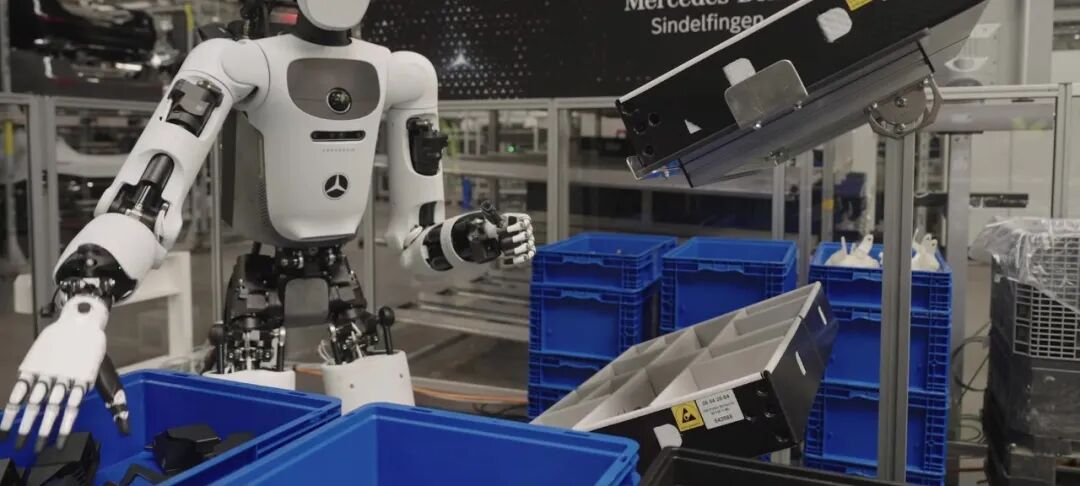
图源:Google DeepMind官方视频截帧(Apollo 2分拣作业中)
试点放在匈牙利凯奇凯梅特和德国辛德尔芬根两座奔驰工厂的在产产线旁。任务叫零部件配套:机器人从散装箱里取出金属支架,按装配顺序放进配套容器,供产线取用。这是汽车工厂里典型的重复性物流工序,节拍明确、动作标准化。DeepMind报告的成功率为96%,并称模型几周的后训练改进就能迁移到产线上,性能衰减很小。Apptronik CEO杰夫·卡德纳斯表态称,这正是Apollo的设计初衷:在真实工业环境里与人并肩干活。
制图:编辑部 · 数据来源:Google DeepMind官方博客
安全能力也同步升级:推理期引导让机器人绕开障碍物的安全作业率提升33%,在人员附近提升43%;针对机器人场景的越狱抵抗率从82%提升到99.5%。
我们的解读
这份发布最值得盯的数字不是96%,而是「四个月」。训练周期从以年计压缩到以月计,意味着机器人「换大脑」的节奏开始向软件发版看齐——仿真练习加失败复盘的组合拳,正是把大模型侧成熟的训练方法论搬进了物理世界。
对工厂侧来说,分拣、配套这类工序会是人形机器人最先吃下的地盘:任务边界清晰、容错可接受、不与人类争抢高精度工位。但也要留一分清醒:96%出自DeepMind自己的报告,试点时长、抓取次数、与人类工人的节拍对比均未披露;通用模型在推理速度和运行成本上的限制仍在。仿真到真机之间的最后一公里,还是要用产能利用率来验证。
本文为编辑部独立采编综述,内容基于公开报道整理。
本文所引用的数据、观点和信息均来源于我们认可的公开资料(如媒体报道、官方发布、企业公告等)并已标注出处。我们不对第三方信息的准确性与完整性提供担保,读者引用或据此决策请自行审慎判断。本文仅作资讯分享,不构成任何投资建议。